Le università europee stanno vivendo un momento “ora o mai più” per il calcolo. I gruppi di ricerca vogliono partizioni GPU più grandi per l'addestramento dei modelli, prestazioni MPI più prevedibili per la simulazione e tempi di consegna più rapidi per i cluster condivisi multi-tenant. Allo stesso tempo, i budget sono sotto esame, gli obiettivi energetici stanno diventando più ambiziosi e le aspettative di sovranità stanno aumentando.
In pratica, molti aggiornamenti di AI e HPC universitari non falliscono a causa di CPU/GPU. Si bloccano perché l'interconnessione non riesce a sostenere un throughput elevato sotto carico senza picchi di latenza imprevedibili. È esattamente lo spazio problematico per cui è stato progettato Cornelis CN5000, e il motivo per cui abbinare la tecnologia Cornelis al modello di distribuzione e consegna europeo di Hammer è un percorso pragmatico per le università che necessitano di prestazioni e sanità operativa.
Cosa cambia quando un cluster universitario diventa “AI + HPC” su larga scala?
Gli ambienti universitari sono particolarmente esigenti perché combinano:
• HPC strettamente accoppiato (collettive MPI, sensibilità alla latenza, job di lunga durata)
• Training AI distribuito (pattern ad alta intensità di banda e comunicazione come all-reduce)
• Multi-tenancy (molti utenti, molte forme di job, concorrenza imprevedibile)
• Vincoli infrastrutturali condivisi (spazio rack limitato, limiti di potenza, cicli di approvvigionamento)
In questo contesto, l'interconnessione diventa il “limitatore silenzioso”. Gli eventi di congestione e la latenza a coda lunga non rallentano solo una singola esecuzione. Distorcono l'equità, sprecano ore di allocazione e rendono difficile fidarsi delle prestazioni.
Cornelis CN5000 in parole semplici: perché è diverso
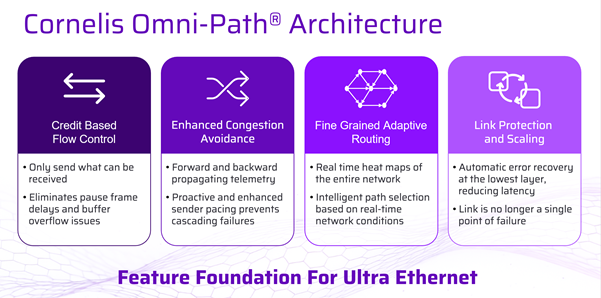
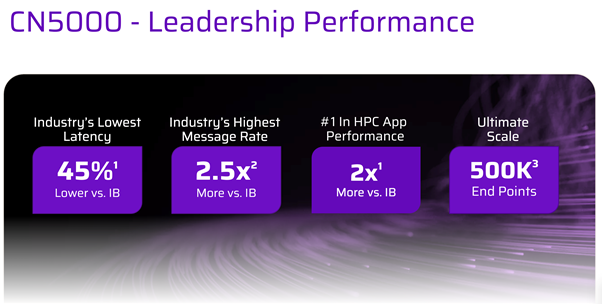
Cornelis CN5000 è una famiglia di interconnessioni HPC/AI end-to-end (switching, interfacce host, cablaggio e software) progettata attorno a un obiettivo semplice: mantenere un throughput elevato e una latenza stabile quando la rete è occupata, che è esattamente la condizione in cui vivono la maggior parte dei cluster universitari.
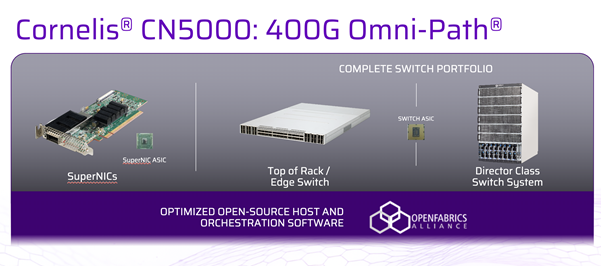
Idee chiave che vedrai associate alle implementazioni CN5000:
• Elevata larghezza di banda per porta per supportare cluster GPU e CPU scale-out
• Comportamento lossless / di prevenzione della congestione volto a uniformare le prestazioni sotto carico
• Routing adattivo e telemetria avanzata per aggirare i punti critici e diagnosticare rapidamente i problemi
• Topologie scalabili da pod più piccoli a grandi fabric multi-rack
Tabella comparativa: CN5000 vs opzioni di interconnessione comuni per le università
La tabella qui sotto è volutamente pratica: riguarda la realtà operativa nell'AI/HPC universitario, non solo i picchi teorici.
|
Ciò che interessa alle università |
Famiglia di prodotti Cornelis CN5000 Omni-Path |
Ethernet (incluse varianti RoCE) |
InfiniBand |
|
Prestazioni prevedibili sotto carico elevato |
Progettato per sostenere il throughput con comportamento consapevole della congestione |
Può essere robusto, ma spesso richiede una messa a punto attenta (PFC/ECN/QoS) per evitare picchi di perdita/latenza |
In genere forte per HPC/AI, ma dipende dalla progettazione della rete e dalla maturità operativa |
|
Sensibilità alla latenza (collettive MPI, job strettamente accoppiati) |
Progettato per l'espansione a bassa latenza pensando all'HPC |
Di solito latenza più alta/irregolare a meno che non sia progettato in modo aggressivo |
Caratteristiche di latenza generalmente eccellenti per i pattern HPC |
|
Equità multi-tenant (dimensioni dei job miste, molti utenti) |
Focus sulla riduzione della variabilità indotta dalla congestione |
Può essere impegnativo senza una QoS disciplinata e una gestione continua delle policy |
Robusto, anche se partizionamento e policy contano ancora su larga scala |
|
Complessità operativa |
Strumenti/telemetria progettati appositamente per la fabric |
Base di competenze familiare, ma l'“Ethernet lossless” può diventare rapidamente complicata |
Competenze specialistiche; strumentazione matura, ma può essere più di nicchia |
|
Prevedibilità dei costi (fabric end-to-end) |
Uno stack fabric a fornitore singolo può semplificare BOM e supporto |
Ampia scelta di fornitori; i costi variano notevolmente in base al design (ottiche, switch, sforzo di ottimizzazione) |
Spesso premium; l'ecosistema è maturo ma può essere più costoso per porta |
|
Ideale per le università |
AI + HPC dove la coerenza delle prestazioni è fondamentale e la congestione è il nemico |
Ambienti misti enterprise + ricerca che valorizzano la standardizzazione e le competenze Ethernet esistenti |
Siti ad alta intensità HPC e centri nazionali dove IB è già la norma |
Come usare questa tabella: se il tuo cluster è composto principalmente da carichi di lavoro piccoli e parallelizzabili in modo banale, la fabric ha meno importanza. Ma se stai facendo training distribuito, simulazioni con uso intensivo di MPI, o stai lottando con prestazioni “altalenanti”, la scelta dell'interconnect diventa una decisione di progettazione di primaria importanza.
Dove CN5000 aiuta di più nei cluster AI e HPC universitari
Un addestramento più veloce non significa solo “più GPU”, ma mantenere le GPU alimentate
L'addestramento distribuito può diventare limitato dalla comunicazione man mano che si scala. Quando la rete si comporta in modo incoerente sotto carico, si osservano cali di utilizzo, stalli di sincronizzazione e tempi di passo irregolari. Una fabric progettata per rimanere stabile sotto concorrenza aiuta le sessioni di addestramento a terminare prima e con meno misteri del tipo “perché quella esecuzione è stata più lenta?”.
Esecuzioni HPC prevedibili in uno scheduler multi-tenant
Le università si preoccupano della latenza di coda perché un singolo rank lento può trascinare l'intero job MPI. Una fabric resiliente alla congestione riduce questi comportamenti di coda lunga e rende le prestazioni più ripetibili nei periodi di carico (la vera prova, onestamente).
Scalare senza “caos di cablaggio”
Man mano che i cluster crescono, la topologia e la strategia di cablaggio possono determinare il successo o il fallimento delle operazioni. Pianificare l'espansione, la densità delle porte, la gerarchia e percorsi sensati per aggiungere rack aiuta a evitare una refactoring a metà ciclo che nessuno ha tempo di fare.
Perché “Cornelis e Hammer” è un abbinamento utile in Europa
Per le università europee, la sfida non è solo scegliere la giusta rete. È approvvigionarsi, integrare, mettere in scena e supportare la soluzione attraverso quadri di procurement, ecosistemi di partner e finestre di cambiamento rigorose.
Il ruolo di Hammer nel canale è prezioso perché può aiutare università e integratori con:
• Disponibilità pratica e approvvigionamento attraverso le rotte di procurement EMEA
• Coordinamento dalla progettazione alla consegna (ottenere il giusto mix di switching, connettività host e cablaggio fin dal primo giorno)
• Pragmatismo del ciclo di vita (strategia per i ricambi, espansioni per fasi e mantenimento della coerenza della rete nel tempo)
In breve: Cornelis porta l'interconnessione progettata su misura; Hammer aiuta a farla atterrare senza intoppi nella realtà delle università europee.
Strategia di migrazione per le università che abbandonano le infrastrutture legacy
La maggior parte delle università non costruisce cluster "greenfield". Di solito si migra da qualcosa come Ethernet più vecchio, generazioni IB legacy, o un mix eterogeneo cresciuto organicamente.
Un approccio di migrazione a basso impatto in genere si presenta così:
- Inizia con un pod CN5000 dedicato
Costruisci una partizione contenuta (spesso GPU-first) con un design leaf/spine (o equivalente) dedicato. Questo ti consente di validare le prestazioni senza interrompere l'infrastruttura esistente. - Utilizzare lo scheduler per gestire l'esperienza utente
Creare partizioni/code chiare affinché i gruppi di ricerca possano aderire alla nuova fabric, quindi standardizzare modelli di job e librerie di comunicazione per la ripetibilità. - Espandi in base alla gravità del carico di lavoro, non alla politica
Sposta prima i carichi di lavoro più intensivi in comunicazione: training distribuito, simulazioni MPI-intensive, analisi su larga scala. Questi mostrano risultati misurabili rapidamente. - Pianifica esplicitamente il percorso di storage
Non lasciare che la rete di storage diventi un ripensamento. Decidi subito se il traffico di storage è separato o convergente e progetta per un comportamento di contesa prevedibile. - Operazionalizza telemetria e runbook
Il miglior interconnect del mondo richiede comunque disciplina day-2: metriche di base, allarmi di congestione e un chiaro percorso di escalation quando le prestazioni cambiano.
Questo metodo a fasi tende a mantenere i ricercatori produttivi mentre la piattaforma evolve sotto di loro.
Considerazioni su procurement europeo, sostenibilità e sovranità
Le università europee devono spesso bilanciare le prestazioni con vincoli che non compaiono in una scheda tecnica:
• Obiettivi di efficienza energetica e rendicontazione del carbonio
Se si monitora l'energia per job o per output di ricerca, la coerenza delle prestazioni è importante perché il tempo sprecato è energia sprecata. Una rete più fluida può ridurre il “consumo di calcolo” causato da stalli e tentativi.
• Sovranità e localizzazione dei dati
Molti progetti ora si preoccupano di dove avviene l'addestramento, dove risiedono i dataset e chi può supportare l'infrastruttura. Scegliere una soluzione con una forte copertura del canale europeo e percorsi di supporto può semplificare la governance.
• Framework, sovvenzioni e finanziamenti a fasi
Gli aggiornamenti dei cluster sono spesso legati alle tappe delle sovvenzioni. Progettare un'interconnessione che si scalda in modo pulito, senza una riprogettazione completa ogni volta che arrivano i fondi, mantiene la roadmap realistica.
È qui che la combinazione Cornelis + Hammer è pratica: supporta un modello di consegna europeo mantenendo il nucleo tecnico focalizzato sui risultati AI/HPC.
Modelli di architettura di riferimento per le università europee che utilizzano CN5000
Modello A: “Partizione AI + partizione HPC classica” su una fabric condivisa
• Partizione AI: nodi GPU (training e fine-tuning), comunicazioni collettive intensive
• Partizione HPC: nodi CPU e acceleratori per simulazione/analisi
• Obiettivo: isolare i vicini rumorosi a livello di scheduler/QoS beneficiando al contempo di una fabric scalabile
Modello B: Pod dipartimentali che si unificano in seguito
Inizia con pod più piccoli, poi espandi man mano che arrivano i finanziamenti. Mantieni la topologia coerente, documenta gli standard di cablaggio ed evita eccezioni “una tantum” che diventano problemi permanenti.
Modello C: Core denso per servizi condivisi e collaborazioni
Se la tua università fa parte di collaborazioni regionali o nazionali, un approccio con core a maggiore densità può ridurre i livelli e semplificare le operazioni man mano che l'infrastruttura cresce.
FAQ: CN5000 su cluster universitari affollati (rifinito + ottimizzato)
In che modo Cornelis CN5000 migliora la coerenza delle prestazioni su cluster universitari affollati?
CN5000 è posizionato come un'interconnessione end-to-end progettata per mantenere un throughput elevato e una latenza stabile quando la fabric è occupata, che è esattamente il momento in cui i cluster universitari multi-tenant faticano. In pratica, questo è importante perché la congestione e la latenza a coda lunga possono rendere le prestazioni “giorni buoni e giorni cattivi”. Una fabric consapevole della congestione aiuta a ridurre il jitter, migliora la ripetibilità e rende più facili da fidarsi i risultati di scheduling equi.
Quando l'interconnessione diventa il collo di bottiglia per l'AI training e l'HPC?
Di solito diventa un vincolo di primo ordine una volta che si superano i piccoli carichi di lavoro parallelizzabili in modo banale. L'addestramento distribuito può diventare limitato dalla comunicazione man mano che si aggiungono più GPU, e i job MPI strettamente accoppiati possono essere rallentati da un singolo rank lento. Negli ambienti multi-tenant, la concorrenza imprevedibile può innescare eventi di congestione che sprecano ore di allocazione e distorcono l'equità tra gli utenti.
Cornelis CN5000 è Ethernet o InfiniBand, e questa distinzione è importante?
L'articolo inquadra CN5000 nella famiglia Omni-Path piuttosto che posizionarlo come Ethernet o InfiniBand. Per la maggior parte dei team universitari, la domanda più utile è se la rete fornisca prestazioni prevedibili sotto un carico reale multi-tenant. Se il tuo problema è la variabilità sotto congestione, l'“etichetta” conta meno di quanto siano stabili latenza e throughput quando il cluster è occupato.
Quali sono le principali differenze tra CN5000, Ethernet/RoCE e InfiniBand per le università?
I compromessi pratici descritti riguardano la realtà operativa. CN5000 è presentato come progettato per prestazioni prevedibili sotto carico elevato, con comportamento sensibile alla congestione e telemetria appositamente costruita. Ethernet può essere familiare, ma l'“Ethernet senza perdite” spesso richiede un'attenta messa a punto per evitare perdite e picchi di latenza. InfiniBand è in genere forte per HPC/AI, ma le scelte di progettazione della fabric e la maturità delle operazioni specialistiche contano ancora su larga scala.
In che modo CN5000 può migliorare l'efficienza del training AI distribuito oltre “l'aggiunta di più GPU”?
Il punto centrale dell’articolo è che un addestramento più rapido spesso deriva dal mantenere le GPU costantemente alimentate, non solo dall’aumentare il numero di GPU. Quando le reti si comportano in modo incoerente sotto carico, si possono osservare stalli di sincronizzazione, cali di utilizzo e tempi di passo irregolari. Una fabric progettata per rimanere stabile sotto concorrenza riduce questi stalli, così l’addestramento termina prima e le prestazioni sono meno misteriose da un’esecuzione all’altra.
Qual è un piano di migrazione a basso rischio per abbandonare Ethernet legacy o interconnessioni più vecchie?
Viene delineato un approccio graduale. Inizia con un pod CN5000 dedicato, spesso GPU-first, per validare le prestazioni senza interrompere l'ambiente esistente. Utilizza lo scheduler per creare partizioni e code chiare, così i team possono aderire e standardizzare i modelli di job e le librerie di comunicazione. Poi espandi in base alla gravità del carico di lavoro: sposta prima l'addestramento distribuito ad alta intensità di comunicazione e la simulazione ad alta intensità MPI, mentre rendi operative la telemetria e i runbook.
Come dovrebbero pensare le università a topologia e cablaggio man mano che i cluster crescono?
L'articolo sostiene che i problemi di scalabilità spesso si manifestano come “caos di cablaggio” e refactoring a metà ciclo di vita. Pianificare l'espansione, inclusa la densità delle porte, la gerarchia e il modo in cui i nuovi rack si uniscono alla rete, aiuta a mantenere le operazioni gestibili. I modelli di riferimento includono iniziare con pod dipartimentali più piccoli che in seguito si unificano, mantenere coerente la topologia e documentare gli standard di cablaggio per evitare eccezioni una tantum che diventano punti critici permanenti.
Perché la rete di storage deve essere pianificata insieme all'interconnect?
Lo storage viene indicato come qualcosa che non dovrebbe essere un ripensamento durante la migrazione o l'espansione. È necessaria una decisione esplicita se il traffico di storage sia separato o convergente, e una progettazione che eviti contese imprevedibili. Senza questo, si può finire con “rallentamenti misteriosi” che sembrano problemi di calcolo ma in realtà sono contese sul percorso di storage sotto carico condiviso.
In che modo i requisiti di sostenibilità e sovranità influenzano le scelte di interconnessione in Europa?
L'articolo evidenzia che le università europee hanno spesso obiettivi energetici, rendicontazione del carbonio e aspettative di governance riguardo alla località dei dati e ai percorsi di supporto. La coerenza delle prestazioni è importante perché il tempo sprecato è energia sprecata, soprattutto quando stalli e nuovi tentativi creano un consumo computazionale. Un design scalabile che cresce in modo pulito con finanziamenti graduali e un modello di consegna europeo può anche semplificare i quadri di approvvigionamento e la governance a lungo termine.
Vuoi saperne di più?