La ricerca e sviluppo automobilistica europea è in una fase di sprint: i programmi di elettrificazione, i veicoli definiti dal software, la validazione ADAS/AV e i gemelli digitali delle fabbriche spingono tutti i carichi di lavoro di simulazione e intelligenza artificiale su cluster GPU/CPU più grandi con cicli di iterazione più serrati.
Il limite nascosto non è più il calcolo. È la rete—spostare gradienti, dataset di sensori, mesh e messaggi MPI abbastanza velocemente da non far arenare i team a causa di latenza di coda, congestione o prestazioni imprevedibili sotto carico.
È qui che si inserisce Cornelis Networks CN5000: un'interconnessione end-to-end progettata su misura per un traffico senza perdite e senza congestione a 400G con latenza MPI sub-microsecondo e gestione della congestione a livello di fabric, basata sull'architettura Omni-Path.
E, abbinato alle capacità di distribuzione e integrazione di Hammer focalizzate sull'Europa, diventa un percorso pratico per le organizzazioni automobilistiche per implementare e supportare reti ad alte prestazioni tra team di ingegneria multi-sito.
Perché l'innovazione automobilistica ora dipende dalla rete
I flussi di lavoro dell'ingegneria automobilistica sono sempre più interconnessi e iterativi:
- Simulazione di crash & sicurezza (grandi job MPI, molti messaggi piccoli, sensibile alla latenza e alla latenza di coda)
- CFD, analisi aerodinamica e termica (grandi decomposizioni di dominio con comunicazione all-to-all)
- Modellazione di batterie ed elettronica di potenza (multi-fisica, grandi insiemi)
- Addestramento della percezione ADAS e della fusione dei sensori (comunicazione collettiva AI distribuita)
- Gemelli digitali di veicoli e impianti (flussi di dati continui, test rapidi di scenari)
Man mano che i cluster crescono, “una buona larghezza di banda media” non è più sufficiente.. I team automobilistici hanno bisogno di:
- Prestazioni prevedibili sotto carico
- Bassa latenza di coda (così il rank/worker più lento non domina il tempo di step)
- Gestione della congestione che regge in condizioni reali di uso misto, non solo nei modelli di traffico migliori
Il CN5000 in un minuto
CN5000 è posizionato come una rete scale-out senza perdite e senza congestione per AI e HPC, progettata per mantenere prestazioni stabili mentre si cresce.
A colpo d'occhio:
- Larghezza di banda 400G per porta
- < 1 µs di latenza MPI (punti salienti di Switch e SuperNIC)
- I blocchi costruttivi architetturali includono:
- Controllo del flusso basato su credito
- Ritrasmissioni a livello di collegamento
- Gestione della congestione a livello di fabric
Routing multipathRouting adattivo a grana fine (FGAR) e controllo del flusso consapevole dell'incast indicati come parte dell'approccio alla gestione della congestione
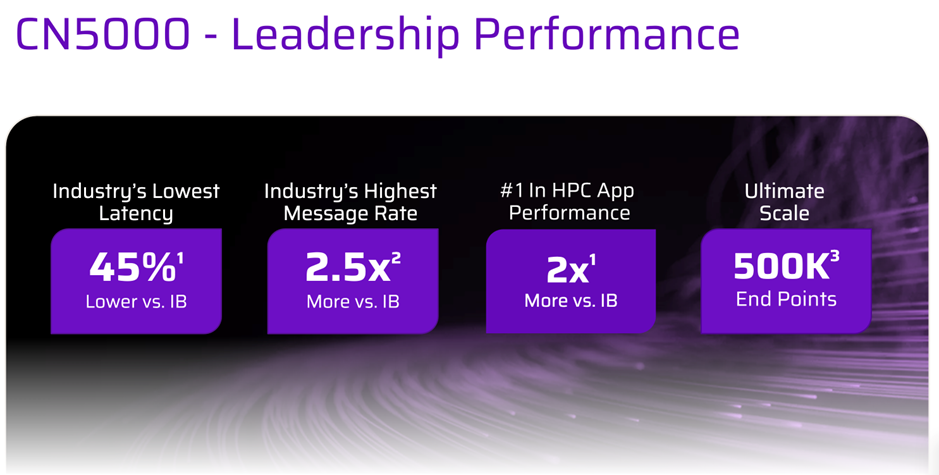
Con oltre 240 ingegneri e tecnologi dedicati al progresso dell'innovazione di rete, Cornelis e Hammer sono focalizzati sullo sblocco di una maggiore efficienza dei data center. Il nostro portfolio completo di SuperNIC e switch si basa sulla nostra eredità di inventori di Omni-Path, un'architettura progettata per offrire le prestazioni di rete più elevate nell'era del scale-out e un set di funzionalità fondamentali per Ultra Ethernet. Offriamo prestazioni leader del settore, tra cui latenza ultra-bassa, velocità di messaggio elevate e prestazioni applicative ottimizzate.
Esempio di impatto per il cliente:
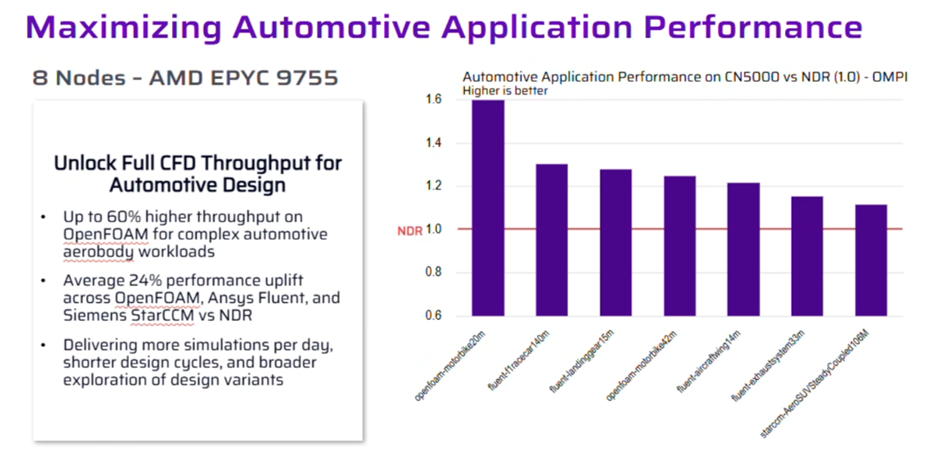
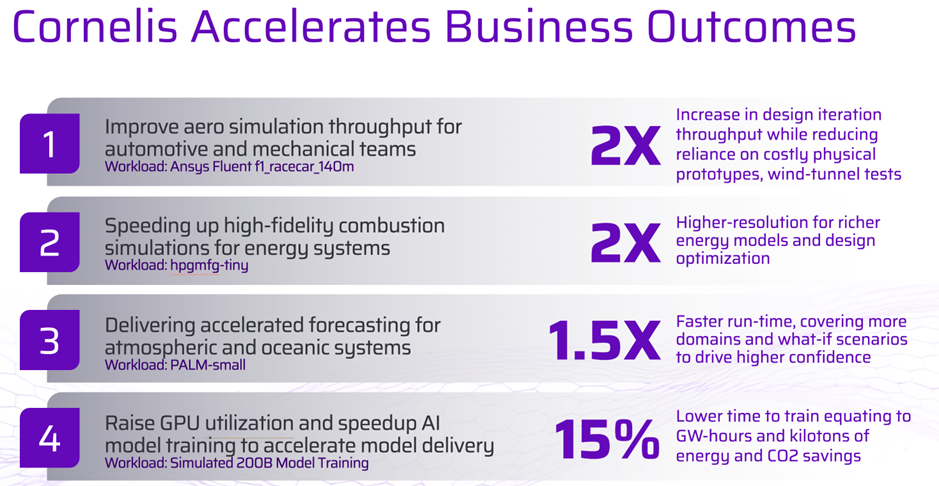
Miglioramento della produttività delle simulazioni aerodinamiche per i team automotive e meccanici, con un aumento fino a 2× della produttività delle iterazioni di progettazione, riducendo al contempo la dipendenza da costosi prototipi fisici e test in galleria del vento.
-
- CN5000 Switch:
- 48 porte da 400G
- CN5000 Switch:
CN5000 vs InfiniBand vs RoCEv2 Ethernet (Confronto focalizzato sull'automotive)
|
Cosa stai confrontando |
Cornelis Networks CN5000 (Omni-Path) |
InfiniBand NDR 400 (es. Quantum-2) |
Ethernet 400G con RoCEv2 |
|
Intento primario |
Fabric scale-out progettato appositamente per AI + HPC con un focus progettuale lossless e congestion-free. |
Fabric HPC/AI con routing adattivo e controllo della congestione come parte del valore della piattaforma. |
Ethernet open-standard adattato per AI/HPC a bassa latenza utilizzando tecniche “lossless” (spesso PFC + ECN + controllo della congestione end-to-end come DCQCN). |
|
Classe di velocità del collegamento |
400G per porta (opzioni Switch e SuperNIC). |
400Gb/s per porta (NDR 400). |
Comunemente Ethernet 400G; RoCEv2 utilizzato per RDMA (dipende dal design/fornitore). |
|
Densità di porte switch 1U (esempio) |
48 × 400G Switch; 38.4T full duplex. |
Spesso 64 × 400Gb/s in 1U (dipende dal modello). |
Varia ampiamente; il comportamento dipende fortemente da ASIC/fornitore e dalle tue scelte di QoS/buffer/ECMP/telemetria e ottimizzazione. |
|
Approccio alla congestione / senza perdite (alto livello) |
Credit-based flow control, link-level retransmissions, fabric-level congestion management, multipath routing—aimed at predictable performance and reduced tail latency. |
Controllo della congestione a livello di piattaforma, QoS/lane virtuali, routing adattivo; può includere funzionalità di accelerazione in rete (specifiche della piattaforma). |
“Ethernet senza perdite” utilizza tipicamente PFC per evitare cadute più ECN per marcare la congestione e segnalare la riduzione della velocità; il successo operativo dipende dalla disciplina di configurazione. |
|
Avvertenze operative |
Trattalo come un sistema end-to-end (Switch + SuperNIC + software) per allinearsi all'architettura prevista. |
Scelta forte dove l'ecosistema/strumentazione IB e i flussi di lavoro esistenti sono consolidati. |
I risultati di RoCEv2 dipendono fortemente da una corretta progettazione PFC/ECN e da una disciplina operativa continua; le configurazioni errate possono creare gravi comportamenti di congestione/latenza. |
Cosa significa “Lossless, Congestion-Free” nei risultati ingegneristici quotidiani
Tempi di risoluzione del solver più rapidi -
Nelle grandi simulazioni MPI, il tempo di esecuzione può essere dominato dalle fasi di comunicazione (scambio di halo, riduzioni, sincronizzazione). CN5000 enfatizza l'ottimizzazione della velocità dei messaggi e della latenza insieme alla gestione della congestione—puntando a prestazioni prevedibili sotto carico.
Migliore efficienza dell'addestramento AI distribuito (stack ADAS/AV e autonomia)
CN5000 si posiziona come una fabric progettata per l'addestramento e l'inferenza AI che mantiene la produttività sotto carico minimizzando gli eventi di congestione e la latenza di coda.
Dove lo sentirai: maggiore utilizzo della GPU (meno tempo in attesa delle collettive), tempi di step più stabili, miglioramento del time-to-train per nuovi domini sensoriali o varianti di modello.
Controllo pratico tramite telemetria (non congetture)
Quando più team condividono la stessa piattaforma, i modelli di traffico possono cambiare di ora in ora. CN5000 evidenzia la telemetria e la visibilità in tempo reale per supportare una gestione del traffico consapevole del carico di lavoro.
Dove lo noterai: individuazione più rapida della causa principale per il jitter delle prestazioni e una pianificazione della capacità più chiara, soprattutto in cluster a uso misto.
Progettazione di CN5000 in cluster HPC e AI automobilistici reali
Trattare la congestione come il caso normale, non come un caso limite
Le piattaforme automotive sono quasi sempre a uso misto: CAE al mattino, training nel pomeriggio, pipeline di digital twin in background e tutti che spingono per “un'altra esecuzione” prima di una scadenza. CN5000 evidenzia la gestione della congestione a livello di fabric, il controllo di flusso incast-aware e il routing adattivo per sostenere le prestazioni sotto carico.
Mantieni la tua storia “lossless” end-to-end
Cornelis definisce la “trasmissione senza perdite e senza congestione” come una proprietà architetturale di CN5000 (Switch + SuperNIC + routing/controllo del flusso). In pratica: specificarlo come sistema, validarlo come sistema.
Vuoi saperne di più?